MASTERONDERZOEK · COMPUTER VISION
Hersentumoren classificeren op basis van MRI-beelden.
Een volledig onderzoeksprototype dat heterogene medische beelden met een convolutioneel model en een gebruiksvriendelijke webinterface omzet in voorspellingen voor vier klassen.
Rapport bekijkenINTERACTIEF 3D-MODEL
Verken het tumormodel.
WAAROM DIT BELANGRIJK IS
Een complex visueel vraagstuk met reële klinische gevolgen.
Tumoren van de hersenen en het centrale zenuwstelsel komen minder vaak voor dan veel andere vormen van kanker, maar hun locatie en heterogeniteit maken beoordeling bijzonder veeleisend. Het project onderzocht hoe computer vision de beeldbeoordeling kan ondersteunen zonder het oordeel van specialisten te vervangen.
Wereldwijde context: IARC Global Cancer Observatory, GLOBOCAN 2022. Het prototype is onderzoekswerk en geen gevalideerd medisch diagnostisch hulpmiddel.
DE UITDAGING
Een model leren visueel vergelijkbare patronen te onderscheiden.
MRI-datasets combineren verschillende resoluties, anatomische aanzichten en opnamecondities. Tumoren kunnen bovendien overeenkomsten vertonen in locatie, vorm en textuur, waardoor de grens tussen klassen moeilijk te leren is.
Daarom lag de nadruk evenzeer op datakwaliteit en experimentele discipline als op de modelarchitectuur: openbare datasets combineren, beelden van onvoldoende kwaliteit verwijderen, klassen balanceren en testbeelden buiten data-augmentatie houden.
MENINGIOMA
Tumor die ontstaat in de hersenvliezen rond de hersenen.
GLIOMA
Tumor die ontstaat in gliacellen en een sterk variabel uiterlijk heeft.
PITUITARY
Tumor rond de hypofyse aan de basis van de hersenen.
GEEN TUMOR
MRI-beelden zonder aanwijzingen voor de drie onderzochte tumorklassen.
ONDERZOEKSPIPELINE
Van ruwe beelden naar een interpreteerbare voorspelling.
- DATADe MRI-dataset voorbereiden
Openbare collecties combineren, ongeschikte beelden verwijderen en trainings-, validatie- en testdata scheiden.
- MODELTrainen met transfer learning
Gecontroleerde augmentatie toepassen en de visuele kenmerken van VGG16 aanpassen om de vier MRI-klassen te onderscheiden.
- UITVOERVoorspellingen evalueren en beschikbaar stellen
Elke klasse evalueren en waarschijnlijkheden via een Flask-applicatie presenteren als numerieke en visuele resultaten.
MODELEVOLUTIE
Het eerste model legde het probleem bloot. VGG16 maakte opschaling mogelijk.
Een eerste CNN voor twee klassen legde de workflow voor voorbewerking en evaluatie vast, maar de kleine dataset leidde tot instabiel validatiegedrag. Het uitbreiden en opschonen van de data verbeterde het experiment voordat het naar vier klassen werd uitgebreid.
Met transfer learning werden de vooraf getrainde visuele kenmerken van VGG16 hergebruikt. Door het grootste deel van het netwerk te bevriezen en de uitvoer aan te passen, werd het trainbare gedeelte voor de classificatietaak teruggebracht tot ongeveer 16.000 parameters.
- EERSTE EXPERIMENTCNN-basismodel met twee klassen
Een eigen netwerk gebruikte 620 beelden om de workflow te valideren. Instabiele validatie bracht overfitting en de beperkingen van een kleine dataset aan het licht.
- DATASET VERBETERENDe trainingsdata uitbreiden en versterken
Meerdere openbare bronnen werden opgeschoond, opnieuw geordend en uitgebalanceerd tot een dataset van 5.320 beelden. Gecontroleerde rotaties, verschuivingen, zoom en spiegelingen vergrootten vervolgens de variatie tijdens de training.
- FINE-TUNINGVGG16 aanpassen aan de vier MRI-klassen
De beelden werden gestandaardiseerd op 224 × 224 × 3. De vooraf getrainde visuele kenmerken bleven behouden, terwijl de classificatie-uitvoer met ongeveer 16.000 trainbare parameters werd aangepast aan de doelklassen.
- RESULTAATSterkere herkenning door rijkere leerdata
De grotere en gevarieerdere invoer verbeterde het leerproces, ondersteunde stabielere generalisatie en leverde betekenisvolle voorspellingen voor vier klassen.
DATASTRATEGIE
Meer data hielp. Beter beheerste data was doorslaggevender.
Het definitieve experiment gebruikte 5.320 MRI-beelden met evenwichtige aantallen per klasse. Een 70/20/10-verdeling scheidde training, modelselectie en eindevaluatie, terwijl augmentatie uitsluitend tijdens de training gecontroleerde rotaties, verschuivingen, zoom en spiegelingen introduceerde.
OPEN ACADEMISCHE DATA
Herkomst van de MRI-beelden.
Het onderzoek combineerde openbaar toegankelijke MRI-collecties voor academische experimenten. Beelden uit de verschillende bronnen werden beoordeeld, opnieuw geordend en gefilterd voordat ze in de gezamenlijke trainingsworkflow werden opgenomen.
FIGSHAREBrain Tumor Dataset3.064 T1-gewogen MRI-beelden met contrastversterking voor drie tumorklassen. CC BY 4.0.KAGGLEBrain Tumor Classification (MRI)Openbare academische collectie met glioom, meningeoom, hypofysetumor en beelden zonder tumor.GITHUBBrain Tumor Detection DatasetOpen referentierepository met MRI-beelden en materiaal voor CNN-experimenten.
EXPERIMENTELE RESULTATEN
Sterke resultaten voor alle klassen, met duidelijke ruimte voor verbetering.
Het model voor vier klassen behaalde een trainingsnauwkeurigheid van 88,17%. Evaluatie per klasse liet zien dat glioom de moeilijkste categorie bleef, wat het belang van visuele gelijkenis en datakwaliteit bevestigt.
VERGELIJKING PER KLASSEReferentie- en modelnauwkeurigheid per klasse
Gepubliceerde referentieToegepast model
Meningioma+21.38 pp
Glioma-4.16 pp
Pituitary-0.74 pp
Geen tumorGeen benchmark beschikbaar
VAN MODEL NAAR PRODUCT
Van getraind model naar functionele applicatie.
Als onderdeel van het onderzoek ontwikkelde ik een webapplicatie die het getrainde Keras-model verbond met een Python- en Flask-backend. Gebruikers konden een MRI-beeld invoeren en waarschijnlijkheden voor vier klassen ontvangen, numeriek en via D3.js-visualisaties. Dit liet zien hoe het onderzoeksmodel een praktische beoordelingsworkflow kan ondersteunen.
Om de volledige inferentieworkflow te demonstreren, werd een MRI-beeld van een hypofysetumor aan de applicatie aangeboden. Het rapport toont het geselecteerde beeld, de waarschijnlijkheid voor elke klasse en de uiteindelijke classificatie van het model.
========================================
MRI-CLASSIFICATIERAPPORT
========================================

INVOERDATA
BESTAND.......... pituitary (654).png
INVOERTYPE....... MRI-BEELD
MODELUITVOER..... VIER KLASSEN

VOORSPELLINGSSCORES
MENINGIOMA....... 0.007176
GEEN TUMOR....... 0.000283
GLIOMA........... 0.051178
PITUITARY........ 0.941363

PRIMAIRE CLASSIFICATIE
LABEL............ PITUITARY
ZEKERHEID........ 94.1363%

RAPPORTSTATUS.... VOLTOOID
EINDE RAPPORT
========================================
VERDELING VAN DE VOORSPELLINGEN
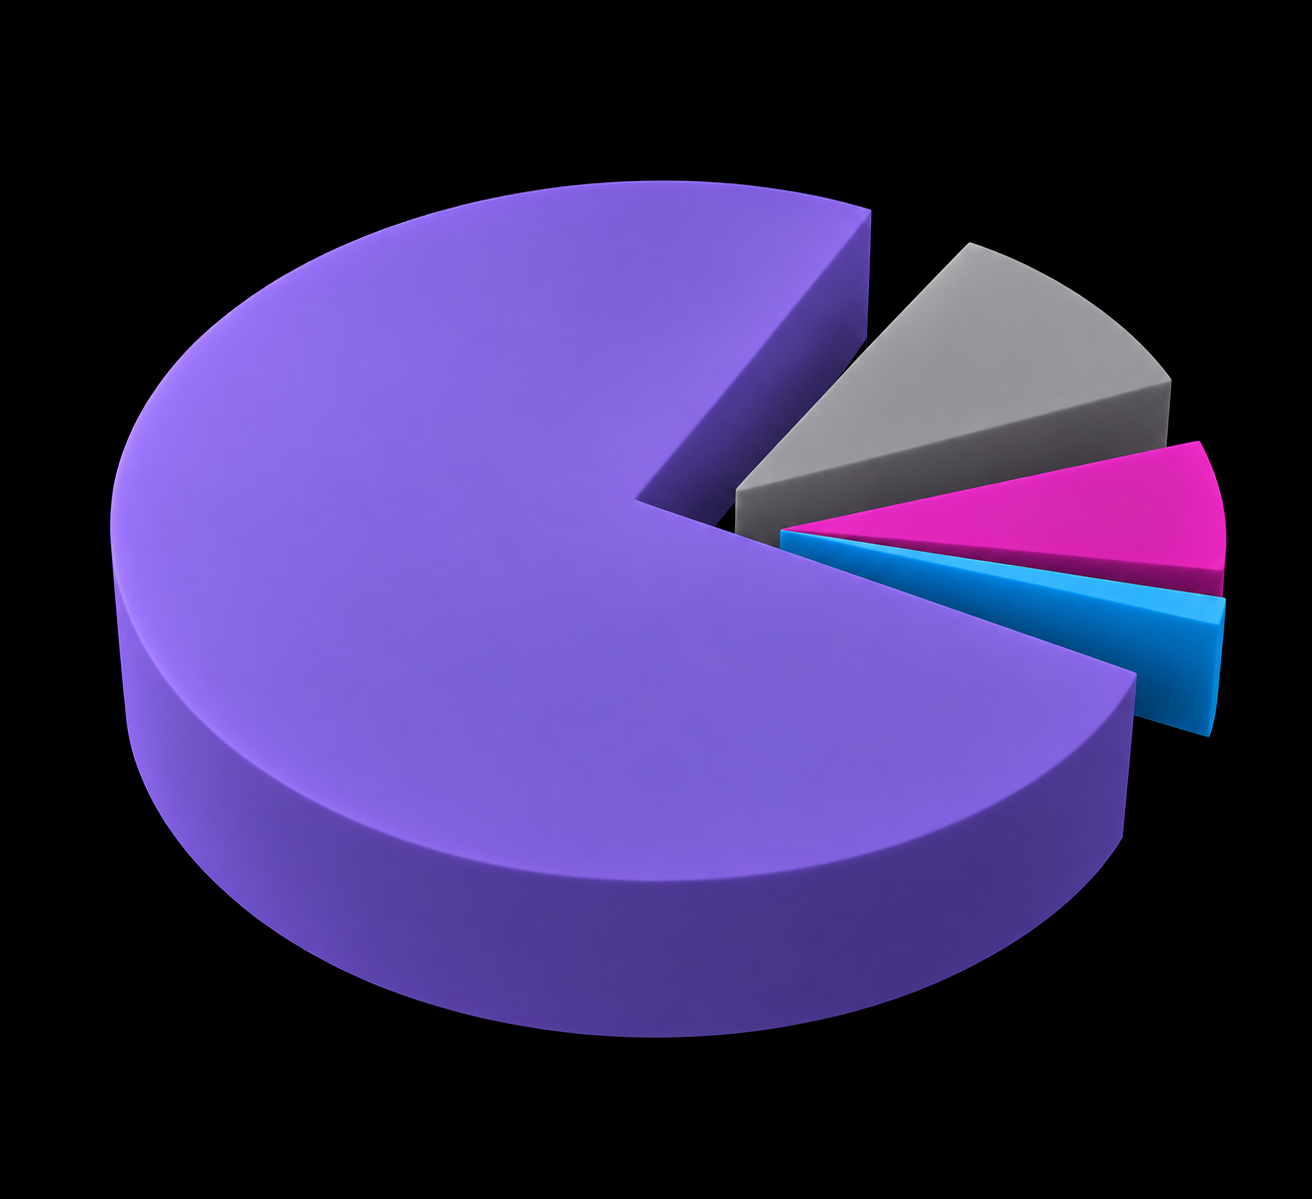
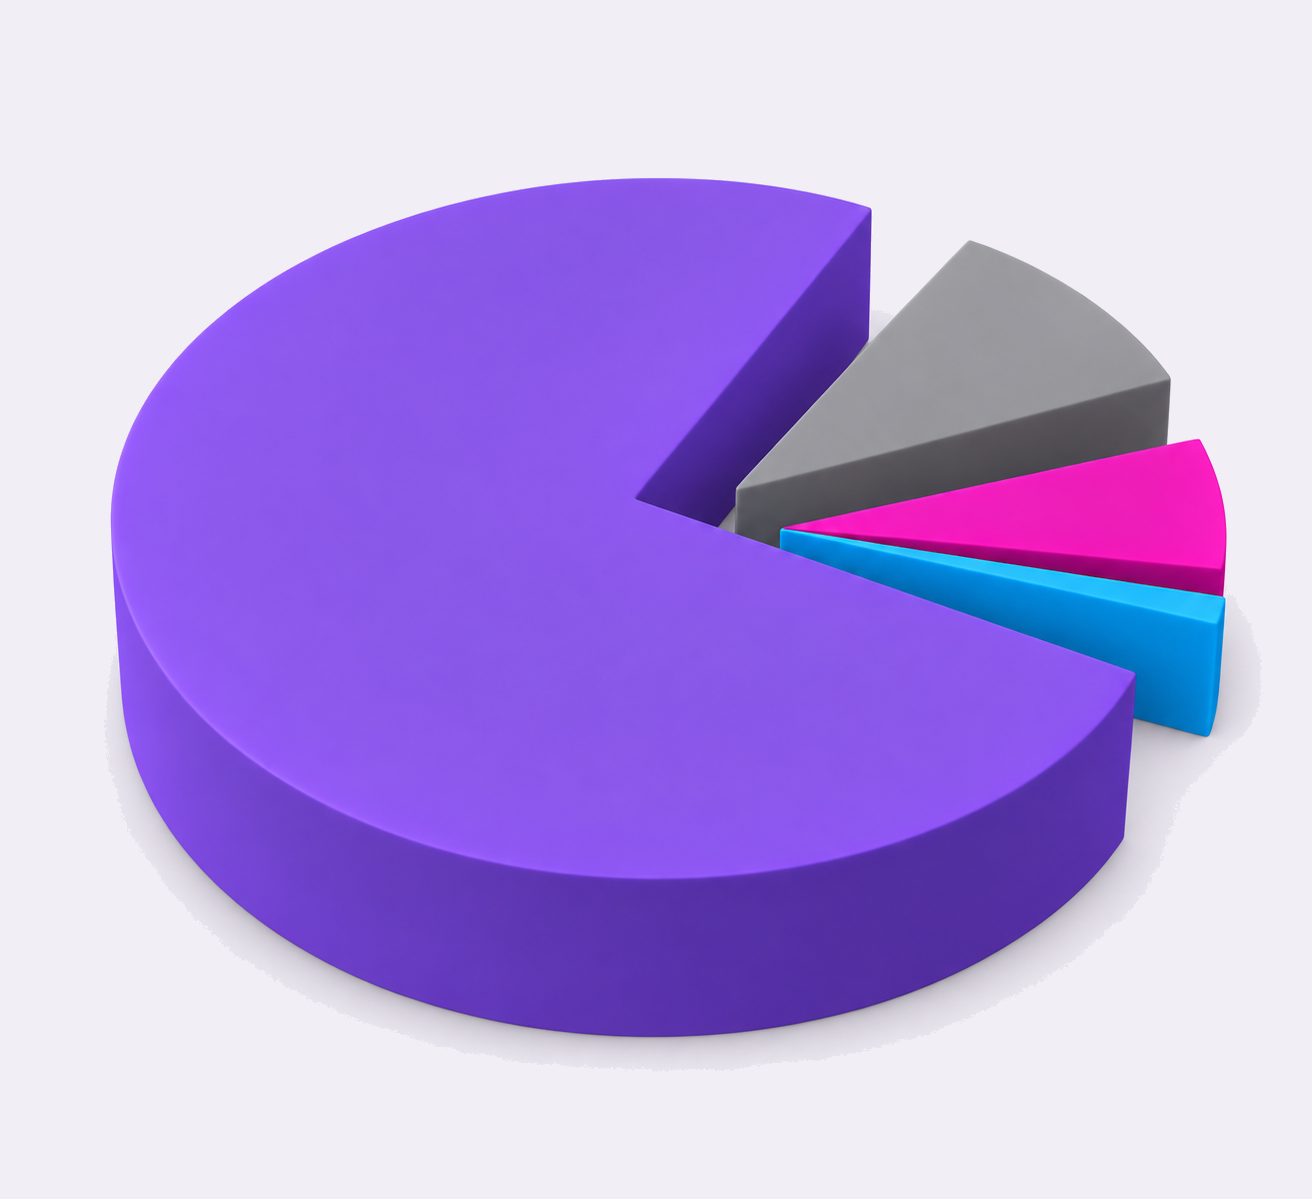
Pituitary94.1363%
Glioma5.1178%
Meningioma0.7176%
Geen tumor0.0283%
VERANTWOORD ONDERZOEK · TECHNISCHE BASIS
Een volledige workflow met een duidelijke klinische afbakening.
De stack verbond modelontwikkeling, versnelde experimenten, backend-inferentie en browservisualisatie in één volledige workflow. Het blijft een onderzoeksprototype voor experimentele ondersteuning en kan een diagnose door gekwalificeerde medische professionals niet vervangen.