MASTERFORSCHUNG · COMPUTER VISION
Klassifikation von Hirntumoren anhand von MRT-Bildern.
Ein vollständiger Forschungsprototyp, der heterogene medizinische Bilder mithilfe eines Convolutional Neural Network und einer benutzerfreundlichen Weboberfläche in Vorhersagen für vier Klassen überführt.
Bericht ansehenINTERAKTIVES 3D-MODELL
Tumormodell erkunden.
WARUM ES WICHTIG IST
Eine anspruchsvolle visuelle Aufgabe mit realen klinischen Folgen.
Tumoren des Gehirns und des zentralen Nervensystems sind im Vergleich zu vielen anderen Krebsarten selten, doch ihre Lage und Heterogenität machen die Beurteilung besonders anspruchsvoll. Das Projekt untersuchte, wie Computer Vision die Bildauswertung unterstützen kann, ohne die Beurteilung durch Fachpersonal zu ersetzen.
Globaler Kontext: IARC Global Cancer Observatory, GLOBOCAN 2022. Der Prototyp ist eine Forschungsarbeit und kein validiertes medizinisches Diagnosegerät.
DIE HERAUSFORDERUNG
Ein Modell darauf trainieren, visuell ähnliche Muster zu unterscheiden.
MRT-Datensätze kombinieren unterschiedliche Auflösungen, anatomische Ansichten und Aufnahmebedingungen. Tumoren können sich zudem in Lage, Form und Textur ähneln, wodurch die Grenzen zwischen den Klassen schwer zu erlernen sind.
Die Arbeit konzentrierte sich daher ebenso auf Datenqualität und experimentelle Disziplin wie auf die Modellarchitektur: öffentliche Datensätze zusammenführen, Bilder unzureichender Qualität entfernen, Klassen ausgleichen und Testbilder von der Augmentation ausschließen.
MENINGIOMA
Tumor, der aus den das Gehirn umgebenden Hirnhäuten entsteht.
GLIOMA
Tumor aus Gliazellen mit stark variablem Erscheinungsbild.
PITUITARY
Tumor im Bereich der Hypophyse an der Gehirnbasis.
KEIN TUMOR
MRT-Bilder ohne Hinweise auf die drei untersuchten Tumorklassen.
FORSCHUNGSPIPELINE
Von Rohbildern zu einer interpretierbaren Vorhersage.
- DATENMRT-Datensatz vorbereiten
Öffentliche Sammlungen zusammenführen, ungeeignete Bilder entfernen und Trainings-, Validierungs- und Testdaten trennen.
- MODELLTraining mit Transfer Learning
Kontrollierte Augmentation einsetzen und die visuellen Merkmale von VGG16 zur Unterscheidung der vier MRT-Klassen anpassen.
- AUSGABEVorhersagen evaluieren und bereitstellen
Jede Klasse bewerten und Wahrscheinlichkeiten über eine Flask-Anwendung numerisch und visuell bereitstellen.
MODELLENTWICKLUNG
Das erste Modell machte das Problem sichtbar. VGG16 ermöglichte die Skalierung.
Ein erstes CNN für zwei Klassen etablierte den Vorverarbeitungs- und Evaluierungsworkflow, doch der kleine Datensatz führte zu instabilem Validierungsverhalten. Die Erweiterung und Bereinigung der Daten verbesserte das Experiment vor der Ausweitung auf vier Klassen.
Transfer Learning nutzte die vortrainierten visuellen Merkmale von VGG16. Durch das Einfrieren des größten Teils des Netzes und die Anpassung der Ausgabe wurde der trainierbare Anteil für die Klassifikationsaufgabe auf rund 16.000 Parameter reduziert.
- ERSTES EXPERIMENTCNN-Basismodell mit zwei Klassen
Ein eigenes Netz nutzte 620 Bilder zur Validierung des Workflows. Instabile Validierung zeigte Overfitting und die Grenzen eines kleinen Datensatzes.
- DATENSATZ VERBESSERNTrainingsdaten erweitern und stärken
Mehrere öffentliche Quellen wurden bereinigt, neu organisiert und zu einem Datensatz mit 5.320 Bildern ausgeglichen. Kontrollierte Drehungen, Verschiebungen, Zoom und Spiegelungen erhöhten anschließend die Variation im Training.
- FINE-TUNINGVGG16 an die vier MRT-Klassen anpassen
Die Bilder wurden auf 224 × 224 × 3 standardisiert. Vortrainierte visuelle Merkmale blieben erhalten, während die Klassifikationsausgabe mit rund 16.000 trainierbaren Parametern an die Zielklassen angepasst wurde.
- OUTCOMEStärkere Erkennung durch vielfältigeres Lernen
Die größere und vielfältigere Eingabe verbesserte das Modelllernen, unterstützte eine stabilere Generalisierung und lieferte aussagekräftige Vorhersagen für vier Klassen.
DATENSTRATEGIE
Mehr Daten halfen. Besser kontrollierte Daten waren entscheidender.
Das abschließende Experiment nutzte 5.320 MRT-Bilder mit ausgeglichenen Klassen. Eine 70/20/10-Aufteilung trennte Training, Modellauswahl und Endevaluierung; die Augmentation führte ausschließlich im Training kontrollierte Drehungen, Verschiebungen, Zoom und Spiegelungen ein.
OFFENE AKADEMISCHE DATEN
Herkunft der MRT-Bilder.
Die Forschung kombinierte öffentlich zugängliche MRT-Sammlungen für akademische Experimente. Bilder aus den verschiedenen Quellen wurden geprüft, neu organisiert und gefiltert, bevor sie in den gemeinsamen Trainingsworkflow gelangten.
FIGSHAREBrain Tumor Dataset3.064 kontrastverstärkte T1-gewichtete MRT-Bilder aus drei Tumorklassen. CC BY 4.0.KAGGLEBrain Tumor Classification (MRI)Öffentliche akademische Sammlung mit Gliom-, Meningeom- und Hypophysentumor-Bildern sowie Aufnahmen ohne Tumor.GITHUBBrain Tumor Detection DatasetOffenes Referenz-Repository mit MRT-Bildern und Material für CNN-Experimente.
EXPERIMENTELLE ERGEBNISSE
Starke Ergebnisse über alle Klassen hinweg – mit erkennbarem Verbesserungspotenzial.
Das Vierklassenmodell erreichte eine Trainingsgenauigkeit von 88,17 %. Die klassenweise Auswertung zeigte, dass Gliome die schwierigste Kategorie blieben, was die Bedeutung visueller Ähnlichkeit und Datenqualität unterstreicht.
VERGLEICH NACH KLASSEReferenz- und Modellgenauigkeit nach Klasse
Veröffentlichte ReferenzAngewandtes Modell
Meningeom+21.38 pp
Gliom-4.16 pp
Hypophysentumor-0.74 pp
Kein TumorKeine Benchmark verfügbar
VOM MODELL ZUM PRODUKT
Vom trainierten Modell zur funktionsfähigen Anwendung.
Im Rahmen der Studie entwickelte ich eine Webanwendung, die das trainierte Keras-Modell mit einem Python- und Flask-Backend verband. Nutzer konnten ein MRT-Bild einreichen und Wahrscheinlichkeiten für vier Klassen erhalten, numerisch und als D3.js-Visualisierung. Dies zeigte, wie das Forschungsmodell einen praktischen Prüfworkflow unterstützen kann.
Zur Demonstration des vollständigen Inferenzworkflows wurde ein MRT-Bild eines Hypophysentumors an die Anwendung übergeben. Der Bericht zeigt das ausgewählte Bild, die Wahrscheinlichkeit jeder Klasse und die endgültige Klassifikation des Modells.
========================================
MRT-KLASSIFIKATIONSBERICHT
========================================

EINGABEDATEN
DATEI............ pituitary (654).png
EINGABETYP........ MRT-BILD
MODELLAUSGABE..... VIER KLASSEN

PROGNOSEWERTE
MENINGIOM......... 0.007176
KEIN TUMOR........ 0.000283
GLIOM............. 0.051178
HYPOPHYSENTUMOR... 0.941363

PRIMÄRE KLASSIFIKATION
KLASSE............ HYPOPHYSENTUMOR
SICHERHEIT........ 94.1363%

BERICHTSSTATUS.... ABGESCHLOSSEN
ENDE DES BERICHTS
========================================
VERTEILUNG DER VORHERSAGEN
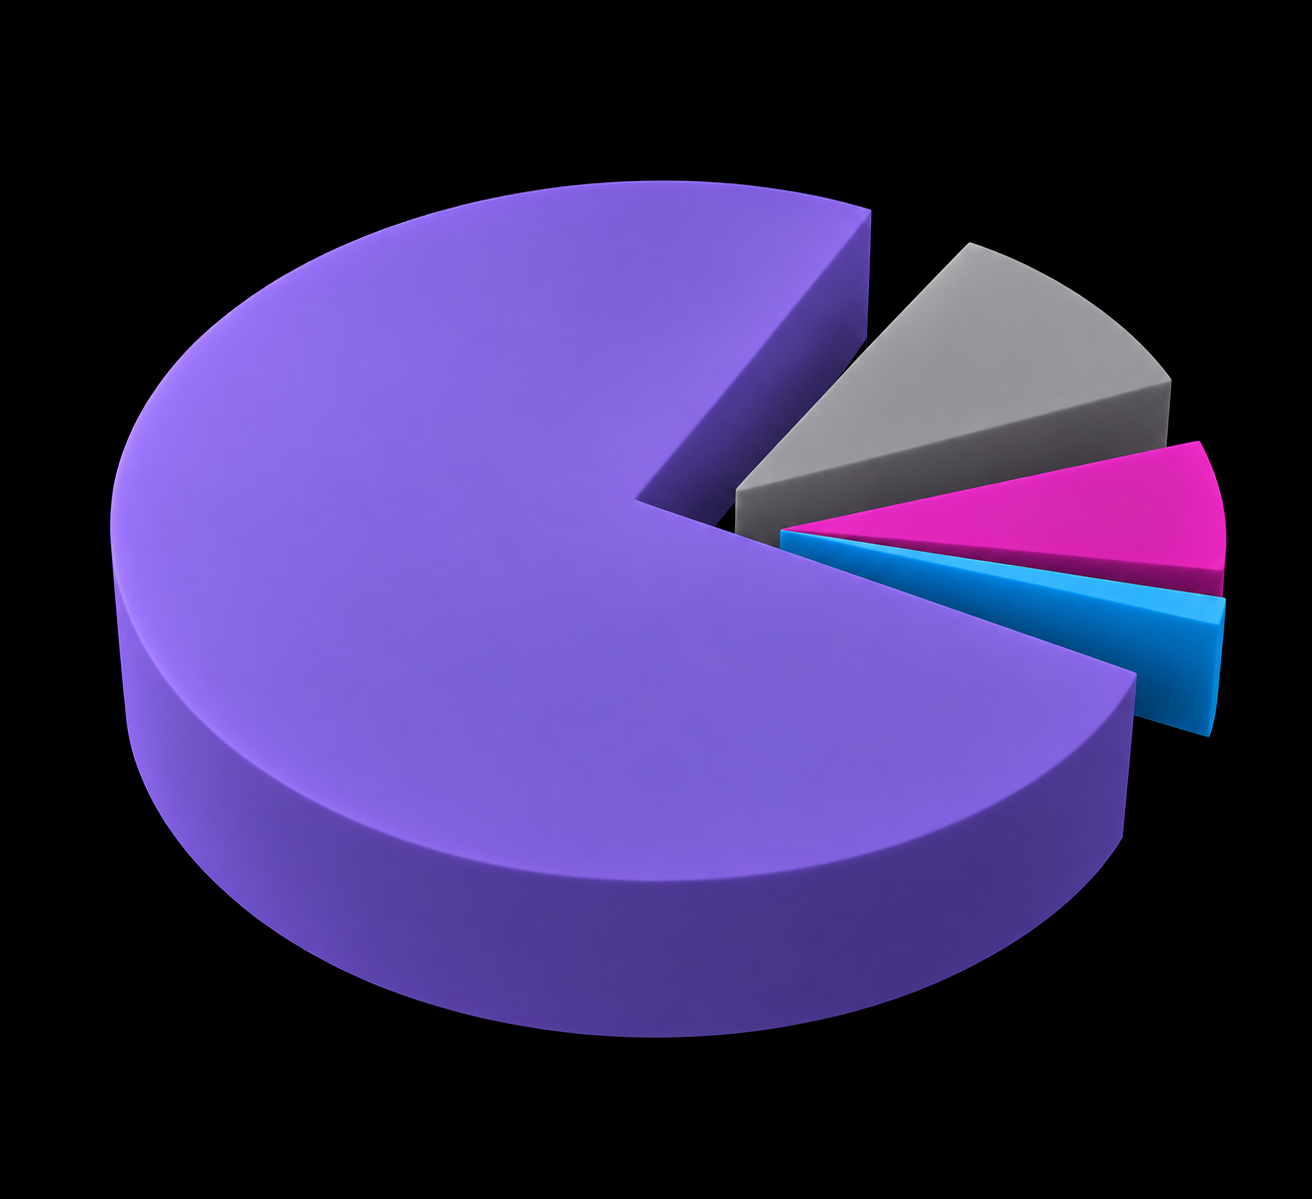
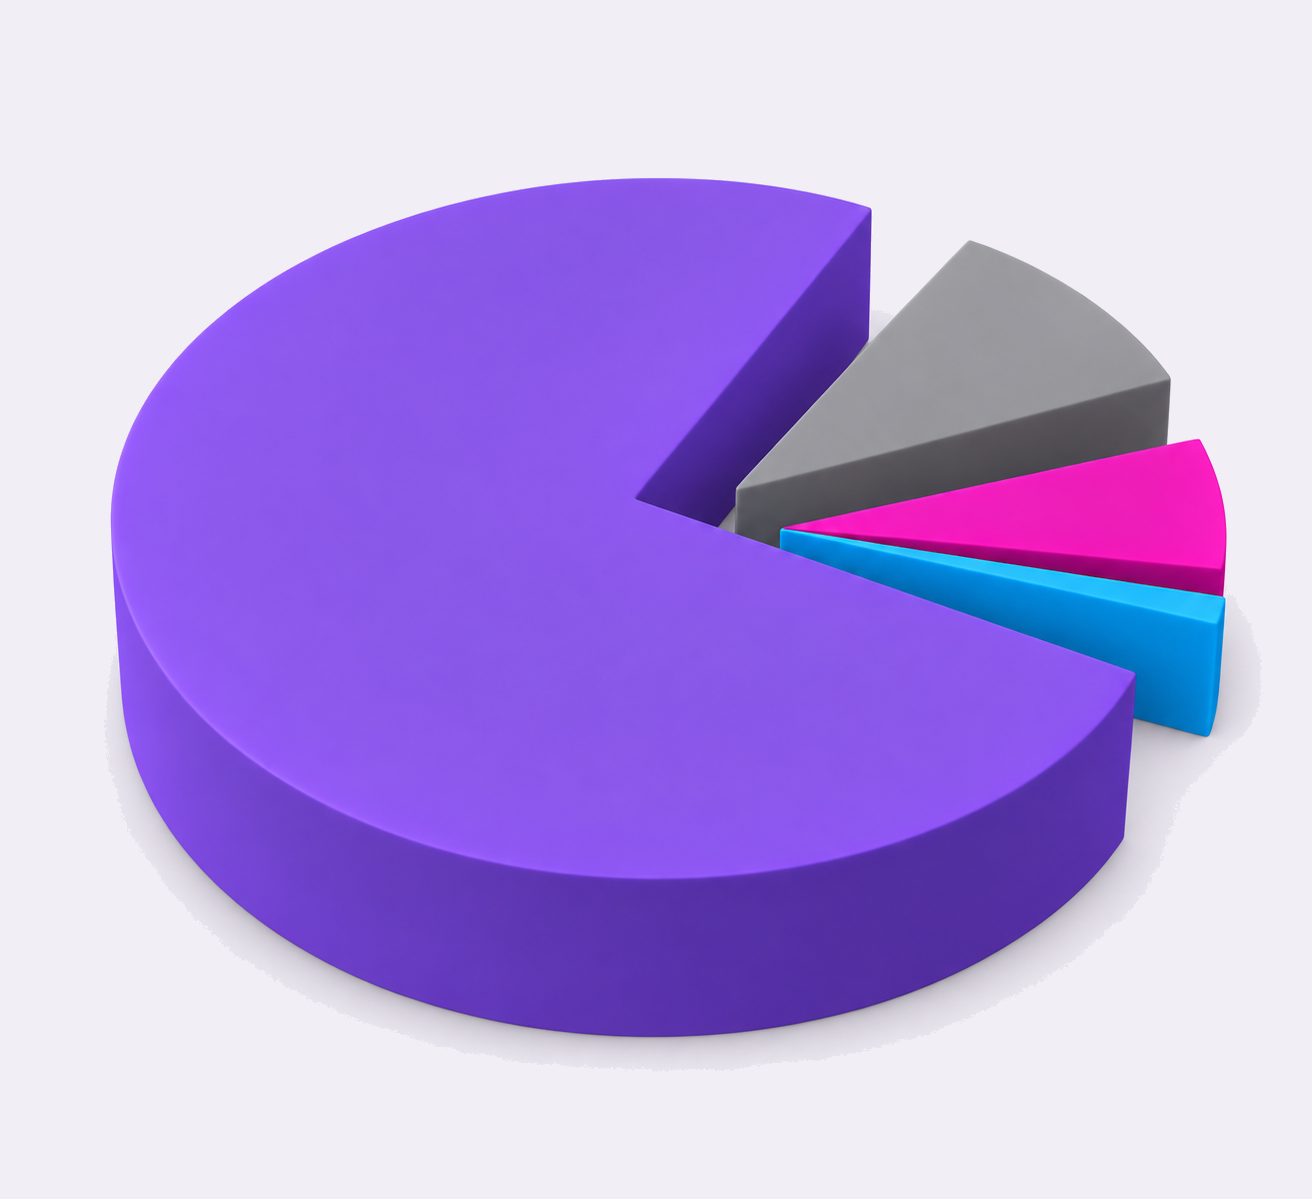
Pituitary94.1363%
Glioma5.1178%
Meningioma0.7176%
Kein Tumor0.0283%
VERANTWORTUNGSVOLLE FORSCHUNG · TECHNISCHE GRUNDLAGE
Ein vollständiger Workflow mit klarer klinischer Abgrenzung.
Der Stack verband Modellentwicklung, beschleunigte Experimente, Backend-Inferenz und Browservisualisierung in einem vollständigen Workflow. Er bleibt ein Forschungsprototyp und kann die Diagnose durch qualifiziertes medizinisches Fachpersonal nicht ersetzen.